16 La ley de decaimiento A(d) ∝ d^−γ
Dónde estamos. En el Cap. 14 vimos por qué la geometría de RoPE limita la resolución con la distancia. Ahora llegamos al corazón de nuestro trabajo: la ley que resume ese decaimiento, por qué es una ley de potencia (no otra cosa), y —lo más importante y único— cómo predecir su exponente γ desde la geometría del modelo, sin entrenar ni ajustar nada. Lo explico paso a paso; no hace falta saber estadística para seguirlo.
16.1 La idea en una frase
La atención media entre dos tokens cae como una ley de potencia con la distancia, A(d) ∝ d^−γ, y el exponente γ se puede predecir desde la geometría de RoPE.
16.2 Conceptos clave y su papel en el transformer
Antes de entrar en detalle, definimos los términos de este capítulo y para qué sirve cada uno dentro de un transformer:
- Ley de potencia A(d) ∝ d^−γ. Definición: la atención media a distancia d cae como una potencia de d. En el transformer: resume en una sola forma cómo reparte el modelo su atención a lo largo de la distancia; en ejes log-log es una recta.
- γ (exponente de decaimiento). Definición: la pendiente (con signo menos) de esa recta log-log; cuánto de rápido cae la atención. En el transformer: es el descriptor central — dice si el modelo mira lejos o concentra cerca.
- Restricción log-distancia. Definición: hipótesis de modelado que fija \(\mathbb{E}[\log d] = \text{constante}\) (un “presupuesto” de log-distancia). En el modelo teórico: es la premisa del cálculo, no una consecuencia general probada de RoPE.
- Máxima entropía. Definición: el principio de elegir la distribución que asume lo mínimo compatible con lo que sabes. En el transformer: aplicado a la restricción log-distancia, da de forma única la ley de potencia (γ es su multiplicador de Lagrange) — una derivación condicional, que debe contrastarse con atención real.
- γ_Padé. Definición: la predicción de γ desde solo θ y T, \(\gamma_{\text{Padé}} = (2\theta - T\sqrt2)/(2\theta + T\sqrt2)\), sin entrenar ni ajustar nada. En el transformer: es nuestro diferencial — predecir el centro de γ a partir de la geometría, no solo observarlo.
- Descomposición de γ. Definición: \(\gamma_{\text{obs}} = \gamma_{\text{geom}} + \gamma_{\text{train}} + \gamma_{\text{arch}} + \varepsilon\). En el transformer: explica de dónde viene cada parte de γ y por qué la predicción geométrica acierta el centro pero no el valor exacto.
- Regímenes (Fase A / Hagedorn / Fase B). Definición: γ<1 (mira lejos), γ=1 (frontera de Hagedorn), γ>1 (concentra cerca). En el transformer: clasifica cómo usa el contexto el modelo, con consecuencias prácticas en los próximos capítulos.
En resumen: la forma (power-law) se deriva, el exponente (γ) se predice de forma aproximada, y la descomposición explica lo que la geometría sola no captura.
16.3 La ley, y qué es γ
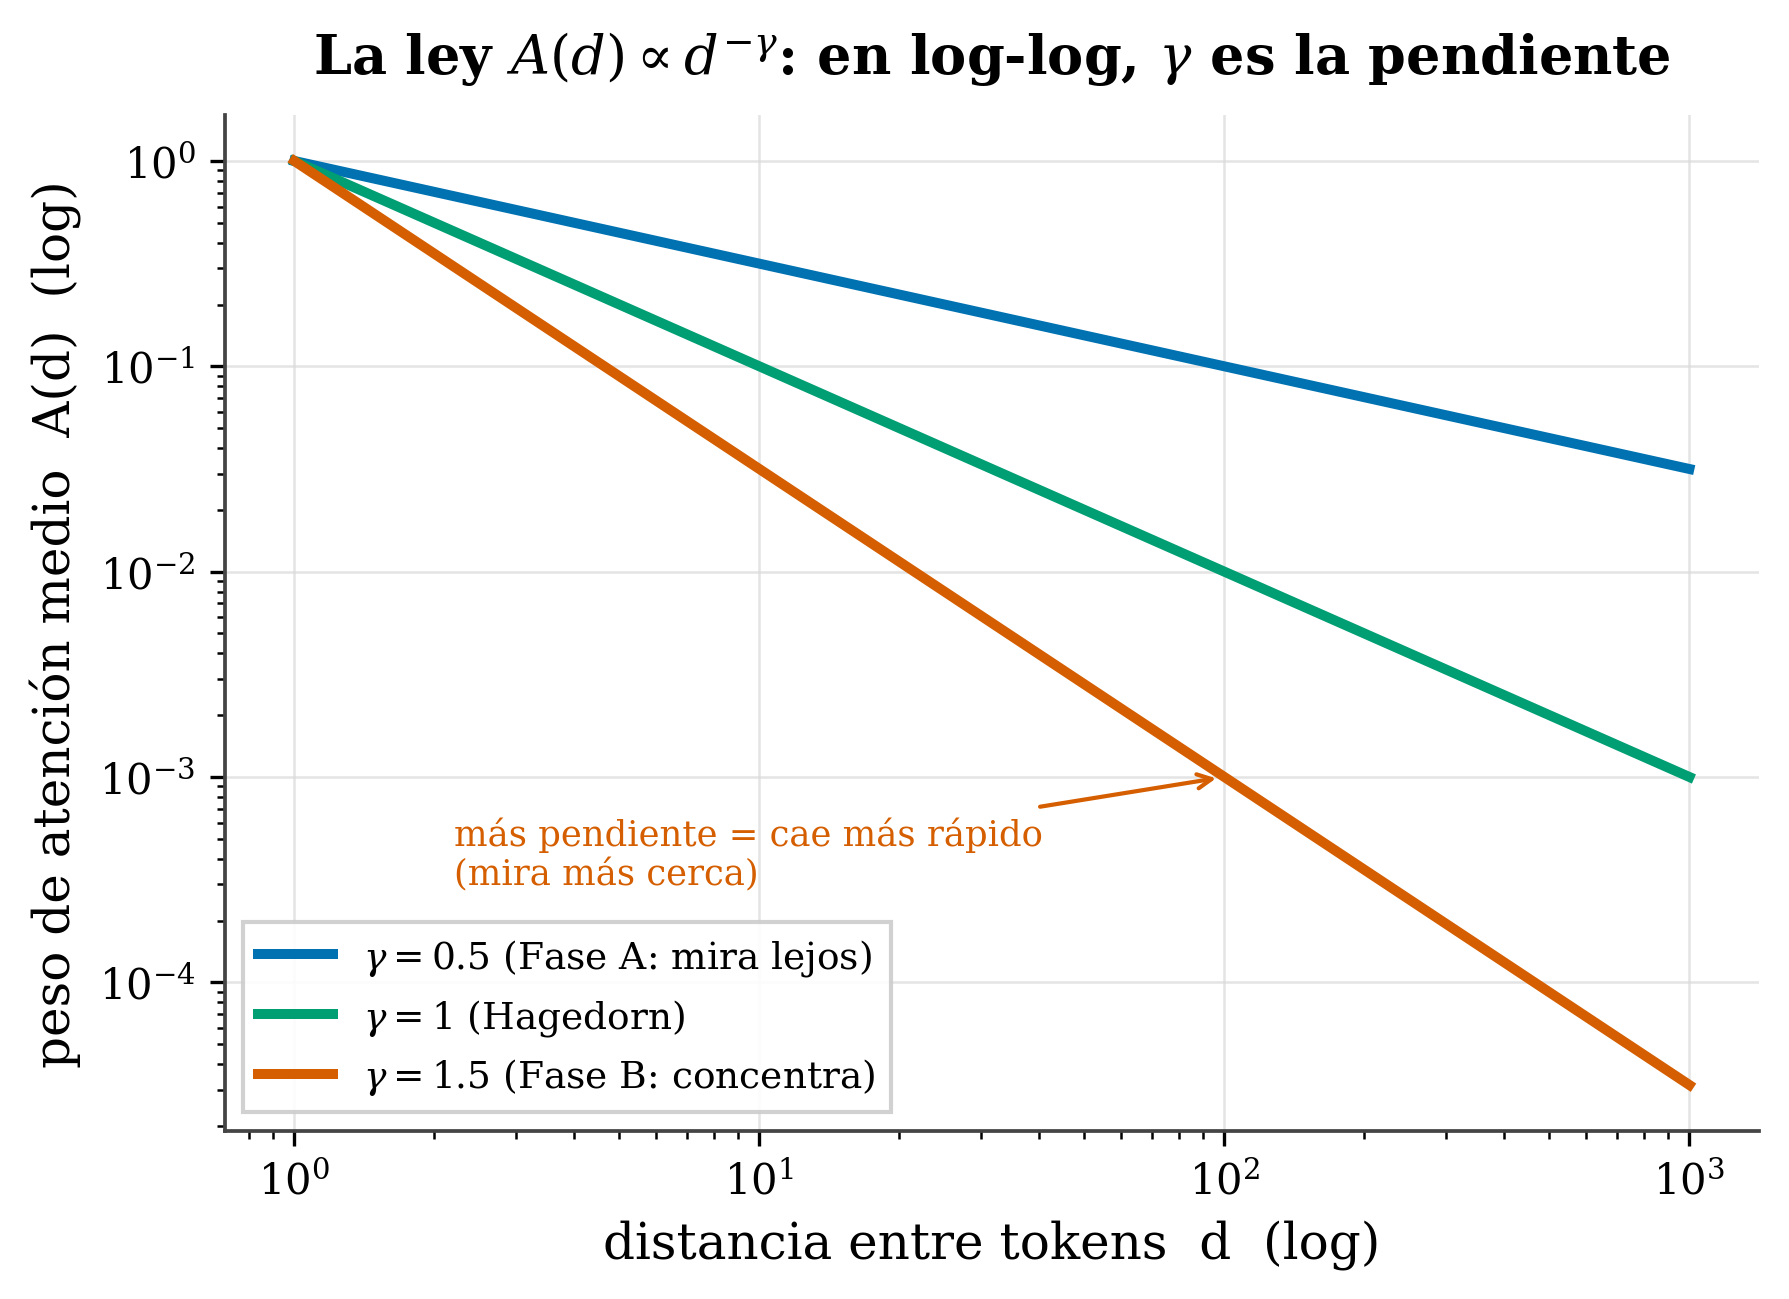
A(d)∝d^−γ en ejes log-log: aparece como una recta cuya pendiente es −γ. γ pequeño (Fase A) = cae despacio, el modelo mira lejos; γ grande (Fase B) = cae rápido, concentra cerca; γ=1 es la frontera (Hagedorn).
Y la misma ley vista como un mapa animado: cada celda es la atención a un token a distancia d, y el color se desvanece con la distancia. Mira cómo, al subir γ, el color se recoge hacia el origen (Fase A, mira lejos → Fase B, concentra cerca):
- A(d) = peso de atención medio a distancia d.
- γ (gamma) = el exponente de decaimiento: cuánto de rápido cae la atención.
Un truco para verlo: en ejes log-log, una ley de potencia es una línea recta, y γ es su pendiente (con signo menos). Medir γ es, literalmente, medir esa pendiente. Muévelo y compruébalo —pulsa «log-log» para ver la recta—:
16.4 ¿Por qué una ley de POTENCIA, y no otra forma?
Esta es la parte bonita —y es nuestra—. La respuesta sale de dos ideas encadenadas.
Paso 1 — proponemos una restricción «log-distancia» motivada por RoPE. Su estructura de frecuencias logarítmica sugiere modelar un presupuesto \(\mathbb{E}[\log d]=\text{constante}\), donde E[·] es el promedio. Es una hipótesis: la geometría por sí sola no obliga a la atención entrenada a satisfacerla. La caja siguiente explica la motivación y dónde falla su interpretación fuerte.
La intuición viene de \(n_{\rm active}(d)\) (Cap. 14). Las longitudes de onda de RoPE están espaciadas geométricamente —\(\lambda_i = 2\pi\,\theta^{2i/d}\): cada una es la anterior multiplicada por el mismo factor—, así que cada duplicación de la distancia “apaga” (aliasa) aproximadamente el mismo número de pares. Se ve en la propia fórmula: \(n_{\rm active}\) cae con \(\log_\theta d\) — lineal en \(\log d\), no en \(d\). Es decir, para RoPE el “coste” de resolver una distancia se paga en log-distancia: pasar de 10 a 100 tokens gasta (en pares) más o menos lo mismo que pasar de 100 a 1000. Y un presupuesto que se gasta uniformemente en \(\log d\) equivale, en promedio, a una restricción sobre \(\mathbb{E}[\log d]\) — justo la del Paso 1. Con ella, el Paso 2 (máxima entropía) hace el resto: \(p(d)\propto d^{-\gamma}\).
Eso es la intuición. Conviene separar qué está derivado y qué no. De la geometría de RoPE se deriva \(n_{\rm active}(d)\), sin entropía de por medio. Y dada la restricción, se deriva la forma \(p(d)\propto d^{-\gamma}\), con γ de multiplicador de Lagrange. Lo que no se deriva es que el entrenamiento lleve realmente a la atención a satisfacer \(\mathbb{E}[\log d]=\text{const}\): es una premisa heurística, sostenida por lo bien que ajusta (Marín 2026).
En su versión fuerte, además, la premisa no cuadra con la medida. Si la geometría fijara el presupuesto, todos los modelos con la misma configuración \((\theta, T)\) compartirían γ. La familia Pythia comparte \(\theta=10.000\) y \(T=2048\), y su γ va de 0,51 a 1,02: el \(\langle \log d\rangle\) que implica cada uno varía un factor 2,5× (un 12 % en la lectura más conservadora, frente al ±5 % que exigiría la premisa).
Sobreviven dos cosas. γ_Padé sigue acertando el centroide de la familia (mediana medida 0,73 frente a 0,747 predicho), y la forma de ley de potencia solo necesita la condición asintótica \(\partial_d \log p \approx -\gamma/d\), que se sigue del aliasing de RoPE sin invocar máxima entropía. La máxima entropía es el andamio que da la fórmula cerrada más limpia, no el cimiento: el cimiento es la geometría, y el valor exacto de γ lo pone el entrenamiento (Cap. 16). (Recibo: part3/experiments/maxent_logd/.)
Paso 2 — máxima entropía. Entre todas las formas de repartir la atención compatibles con esa única restricción, ¿cuál elegir?
🧩 Analogía. Si lo único que te dicen de un dado es que su media sale 3,5, la apuesta más honesta es que el dado es justo (uniforme): no inventas sesgos que nadie te ha dado. Eso es la máxima entropía: la distribución que asume lo mínimo compatible con lo que sabes. (Es el mismo principio que en física da la distribución de Boltzmann.)
Y aquí está el resultado matemático clave: la distribución de máxima entropía compatible con “E[log d] fijo” es, de forma única, una ley de potencia \(p^*(d) \propto d^{-\gamma}\). Ni exponencial, ni gaussiana, ni con corte: solo la power-law cumple las dos cosas a la vez. El exponente γ es el “multiplicador de Lagrange” de esa restricción —en cristiano, la perilla que la restricción fija, no algo que pongamos a mano—.
En un soporte de distancias fijado, maximizar entropía bajo normalización y una media logarítmica admisible da una ley de potencia. Ese resultado matemático es condicional: no demuestra que RoPE imponga la restricción ni que un transformer maximice esa entropía. La forma observada y la predicción de su exponente necesitan sus propios controles.
16.5 Lo verdaderamente único: PREDECIR γ desde la geometría
Que la atención decae como power-law es algo que también observan otros (p. ej. Attention’s Gravitational Field (Zhang 2026), lo ajusta por cabeza). Nuestro diferencial no es ver el decaimiento, sino predecir su exponente —sin ajustar nada— a partir de solo dos números: la base θ de RoPE y la longitud T:
\[ \gamma_{\text{Padé}} = \frac{2\theta - T\sqrt2}{\,2\theta + T\sqrt2\,} \]
Qué hace cada término:
- θ = la base de RoPE (un hiperparámetro del modelo, p. ej. 10000). Al subir θ, el numerador y el denominador se parecen cada vez más → γ → 1 desde abajo (la cola predicha cae más deprisa a T fijo).
- T = la longitud de contexto que evalúas. Al subir T, el término
T√2pesa más → γ baja (la cola cae más despacio si γ sigue siendo positivo). - √2 = una constante que sale de la geometría de RoPE.
- El conjunto numerador/denominador es una transformada de Cayley: comprime la pugna entre θ (escala posicional) y T√2 (contexto largo) en un γ acotado.
Esto da el valor central de γ antes de entrenar nada. Juega con θ y T y mira cómo cambia γ y el régimen (los botones cargan modelos reales):
Tres salvedades que hacemos explícitas (y que nos distinguen de vender humo): 1. La predicción es aproximada. γ_Padé predice el centroide de una familia con un error mediano del 4,3%, y los modelos individuales con una mediana de ~15% y una media de ~30% (Part I, NR-13); el ~20–22% que se cita para la Fase A es esa misma dispersión por modelo. Las dos cifras están publicadas en Part I y miden cosas distintas — la segunda no es una corrección de la primera. γ_Padé acierta el centro, no el valor exacto. 2. No afirmamos que RoPE imponga el decaimiento. Como vimos en el Cap. 14 (Round and Round (Barbero et al. 2024), HoPE (Chen et al. 2024)), la geometría acota la resolución alcanzable; γ describe lo que hacen los modelos entrenados, no es un decreto. 3. La ley es robusta como descripción: A(d)∝d^−γ ajusta con R² > 0,95 en 64 de las 79 medidas del atlas (42 modelos únicos, de Pythia-14M a BLOOM-7B; mediana R²=0,98). Lo sólido es la forma; lo aproximado es predecir el exponente exacto.
16.6 Por qué la predicción no es perfecta: la descomposición
γ medido no es solo geometría. Lo descomponemos para saber de dónde viene cada parte:
\[ \gamma_{\text{obs}} = \underbrace{\gamma_{\text{geom}}(\theta, T)}_{\text{lo que predecimos}} + \gamma_{\text{train}} + \gamma_{\text{arch}} + \varepsilon \]
- γ_geom = lo que fija la geometría (= γ_Padé). Lo que entendemos analíticamente.
- γ_train = lo que añaden los datos de entrenamiento (la formación de induction heads; aparece a partir de ~400M parámetros).
- γ_arch = lo que añade la arquitectura (GQA, ventana deslizante).
- ε = residuo.
Ese ~20% de error de la predicción no es ruido inexplicado: es, en buena parte, γ_train + γ_arch. Por eso γ_Padé predice el centro y la descomposición explica el resto. (Honesto: el término γ_train/imprint —cuya pendiente ν≈−1/2π mediría cuánto “imprimen” los datos de entrenamiento su huella en γ— es provisional —lo veremos con esa salvedad—.)
16.7 Los regímenes: γ<1, γ=1, γ>1
El valor de γ dice cómo usa el contexto el modelo (lo desarrollamos en los próximos capítulos):
- γ < 1 (Fase A): cola pesada, mira lejos → aprovecha contexto amplio.
- γ = 1 (Hagedorn): la frontera entre ambos.
- γ > 1 (Fase B): concentra cerca (mucha masa en poco contexto).
En tafagent, modo Diagnose, pega un model id: te calcula γ_Padé (predicho desde θ y T), lo compara con γ_observado, y te dice en qué régimen (Fase A/B) cae tu modelo y su horizonte efectivo. Es, literalmente, esta teoría hecha herramienta.
16.8 Resumen
- La atención decae como ley de potencia
A(d)∝d^−γ; en log-log, γ = −pendiente. - Por qué power-law: es la única distribución de máxima entropía compatible con una restricción log-distancia asumida; γ = multiplicador de Lagrange. La derivación no prueba que RoPE imponga esa premisa.
- Lo único nuestro: predecir γ desde la geometría (γ_Padé, cero parámetros) —no solo observarlo—.
- Honesto: la predicción es aproximada y sus errores dependen de la muestra y del nivel de agregación; no extrapoles una cifra de centroides a modelos individuales. El atlas respalda la descripción power-law en su protocolo (R²>0,95 en 64 de 79 medidas), no un decreto geométrico sobre todos los modelos.
- Descomposición γ_obs = γ_geom + γ_train + γ_arch + ε explica por qué la predicción no es exacta.
- Regímenes: γ<1 mira lejos · γ=1 Hagedorn · γ>1 concentra.
Siguiente (Capítulo 16): si podemos medir γ en cualquier modelo, midámoslo en muchos — el atlas γ de 42 modelos (79 medidas), el mapa cross-arquitectura que nadie más tiene.
16.9 Ejercicios
- La pendiente. En unos ejes log-log ves dos rectas de atención, una con pendiente −0,4 y otra con −1,3. ¿Cuál mira más lejos? ¿Cuál es Fase A y cuál Fase B?
- Máxima entropía. Con tus palabras: ¿por qué “la distribución más honesta dado solo E[log d]” es la power-law y no una gaussiana?
- Predicción honesta. Si γ_Padé predice 0,7 y el γ medido es 0,55, ¿qué término de la descomposición podría explicar la diferencia?
- Herramienta. ¿Qué tres cosas te devuelve tafagent al perfilar un modelo respecto a γ?
La derivación completa de γ_Padé, la descomposición de seis ejes y los datos que sustentan este capítulo están en abierto: Predicting How Transformers Attend (Zenodo).